🚀 AI Agent 入门
本书的概念地图:从实践出发建立 Agent = LLM + 上下文 + 工具 的最小公式,并一次性命名 ReAct 循环、Harness 工程与贯穿全书的设计模式,为后续各章提供统一的术语与参照坐标。
🧬 核心公式
原图 0-1
Agent = LLM + 上下文 + 工具(大脑 + 眼睛 + 手脚)
三层映射:直觉层 大脑/眼睛/手脚 ↔ 实现层 LLM/上下文/工具 ↔ 学术层 策略/观察与历史/观察-行动接口。公式只描述 Agent 边界内的实现,不包含环境。
🎯 核心论点
1
最小工程公式——Agent = LLM + 上下文 + 工具,三者缺一不可;LLM 对应策略,上下文对应观察与历史,工具对应观察/行动接口。
2
接口即杠杆——模型固定时,扩展观察空间与动作空间(上下文与工具)是最主要的工程手段:"许多看似需要更聪明模型的问题,其实只是接口问题"。
3
上下文组件并不等价——上下文 = 静态前缀 + 轨迹;消融实验证明"给出了回答"≠"完成了任务"。
4
Harness 工程才是竞争力——模型能力正在商品化,生产重心从"能做事"转向"可靠地做事"。
5
ReAct 循环是运行主线——思考 → 行动 → 观察 的迭代,轨迹逐轮追加,带来可解释、可调试。
6
工程范式层层演进——提示工程 ⊂ 上下文工程 ⊂ Harness 工程 ⊂ Loop 工程 ⊂ Graph 工程。
🗂️ 关键概念卡片
Agent 公式
大脑+眼睛+手脚,三者缺一不可LLM+上下文+工具的组合,只描述 Agent 边界内实现,不含与之交互的环境
ReAct 循环
想→做→看,不断迭代直到完成模型思考、调工具行动、观察结果再思考;轨迹逐轮追加驱动任务推进
轨迹 Trajectory
任务全程的"账本"执行中累积的消息历史:用户消息、模型回复(思考+工具调用)、工具执行结果
Harness
套住烈马的缰绳挽具Agent 边界内、模型之外的运行与治理层:上下文管理+工具接口+约束+验证+纠正
工具调用
让模型能动手执行操作声明工具→模型决定调哪个传什么参数→框架执行→结果追加回上下文,共四步
静态前缀
每次都不变的开头系统提示词+工具定义,每次调用自动拼接在轨迹之前,保持稳定
Model as Agent
模型自己决定调工具强化学习把工具调用决策策略内化为原生能力;编排从客户端移到服务端
能力更新三路径
临场适应/可控积累/参数内化上下文适应、外部产物更新、后训练参数更新——三个时间尺度协同
护栏
分层安全防线上下文层(看到什么)、执行层(能做什么)、数据层(世界变成什么样),按被绕过难度排序
五个设计模式
全书复用套路提议者-审核者、渐进式披露、只增不改、边界集+保留集、最小diff+可回滚
🖼️ 原书配图详解
图 1-1
Agent 与 Environment 的闭环交互 + Model–Harness 内部结构
外层:Agent↔Environment 闭环(观察/行动接口);内层:Model–Harness 结构(上下文、工具接口、循环、权限、验证与纠正)。这是全书所有架构的边界。
图 1-2 能力更新三层次:上下文适应(临场)→ 外部产物(任务间)→ 参数更新(训练周期)
图 1-3 实验 1-1 上下文消融实验设计:完整基线 + 四组各缺一组件共五组对照
图 1-4 多币种汇总任务的 ReAct 循环轨迹——轨迹随"思考-行动-观察"逐轮增长
图 1-5 "模型即 Agent"架构——服务端闭环编排,Kimi K3 / GPT-5.6 的实际 ReAct 执行
图 1-6 自主 Agent 执行循环:执行路径不由预定义节点固定,而由环境反馈实时决定
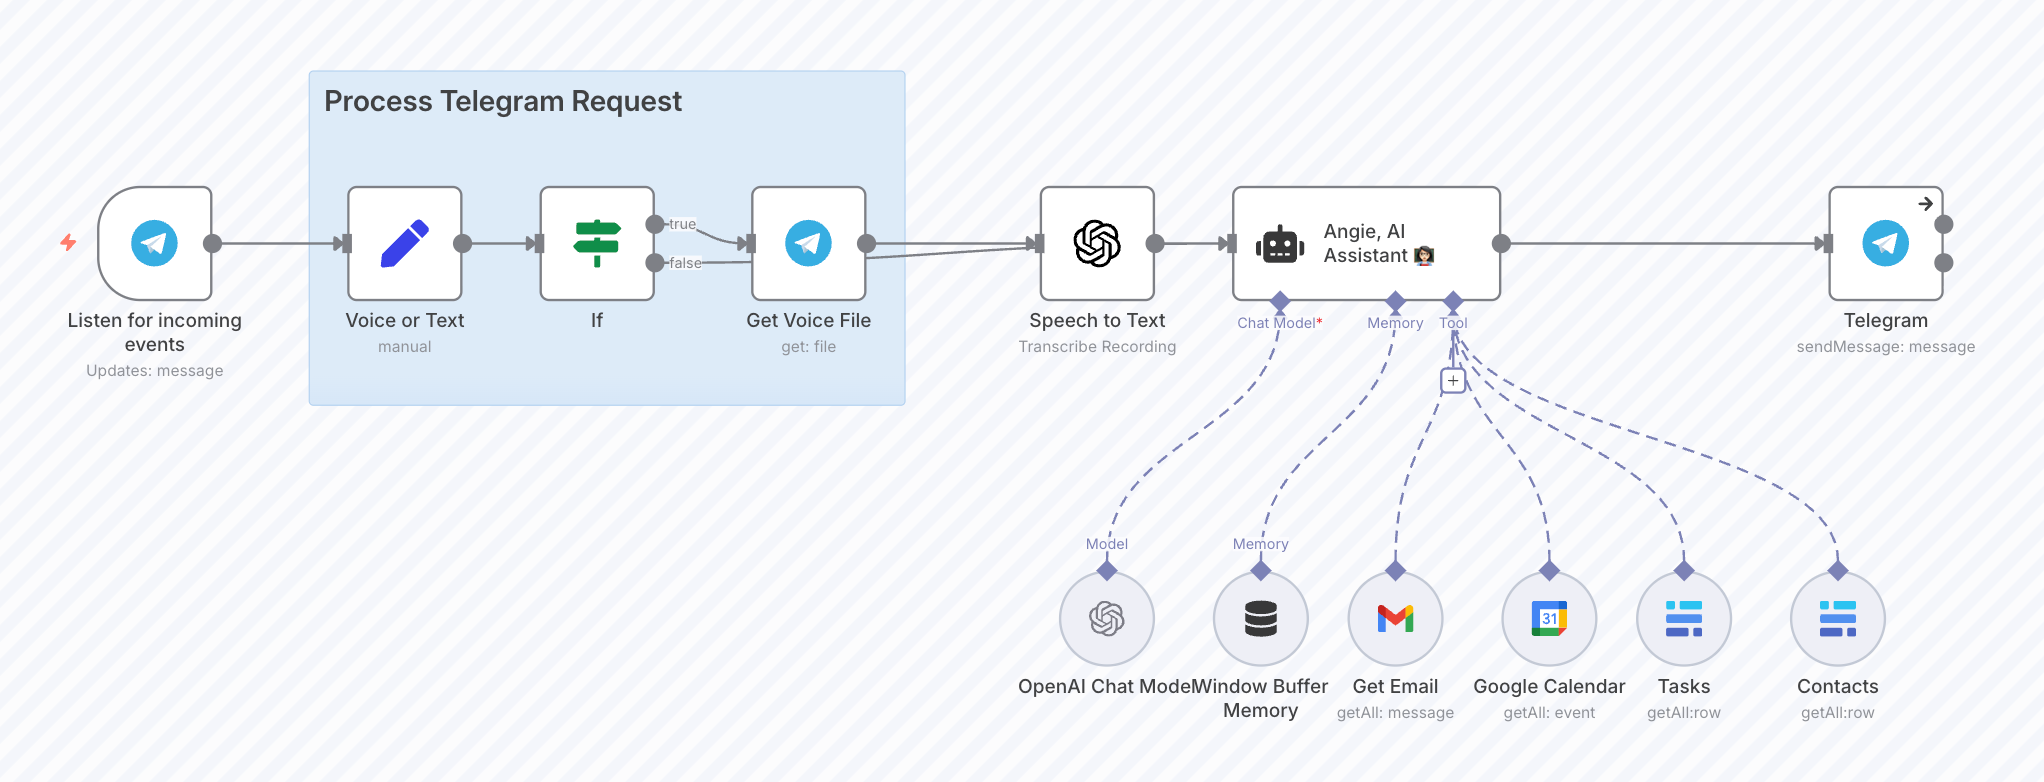
图 1-7(截图) n8n 工作流编辑器——工作流(固定节点)与自主 Agent 可在同一系统混合使用
📊 关键案例与数据
| 案例 / 数据 | 要点 |
|---|---|
| Manus | 率先把 Deep Research、Coding、Computer Use 放进同一生产级 Agent:虚拟浏览器扩大观察空间,文件系统/代码执行扩大动作空间 |
| OpenClaw | 本地优先常驻助手,支持 20+ 消息渠道(WhatsApp/Telegram/Slack/iMessage),本地 Gateway 连接 Google Drive/Notion |
| Kimi K3 | 约 2.8 万亿参数 MoE、100 万 token 上下文,可连续 200~300 次工具调用保持思考一致性 |
| LangChain Terminal Bench 2.0 | 得分 52.8% → 66.5%(只改 Harness 不改模型)——Harness 的竞争力实证 |
| 上下文消融(实验1-1) | 工具定义缺失 → 模型照答但数据来自参数记忆;工具结果缺失 → 盲目重试耗尽预算 |
💬 金句摘录
上下文决定了 Agent 能看到什么,而 Agent 只能基于它看到的信息做决策。
"给出了回答"不等于"完成了任务",上下文残缺时典型的失败不是报错退出,而是一个看上去毫无破绽的答案。
模型每内化一层,Harness 就卸下一层,转而兜底新的能力前沿。
行业正在从"能做事"向"可靠地做事"转变,Harness 工程因此成为 Agent 系统的核心竞争力。
🧪 配套实验亮点
实验 1-1 上下文消融(★★)五组对照证明组件不等价
实验 1-2 Kimi K3 原生 Agent 能力(★)RL 内化"决策"而非"工具执行"
实验 1-3 GPT-5.6 原生 Deep Research(★)自由格式工具调用 + 意图澄清
实验 1-4 文生图工作流 vs 原生图像生成(★)适配层正被模型内化
🔁 贯穿全书的运行机制
ReAct 循环——思考 → 行动 → 观察,第 1 章与全书最重要的运行主线
上下文即消息列表——四种消息角色 + tools 字段构成每轮输入