📚 用户记忆和知识库
把上下文管理从单次会话扩展到跨会话的持久化知识体系,按"个体尺度(用户记忆)与群体尺度(知识库)"两条线索展开——让 Agent 既能"懂你",也能成为"领域专家"。
🎯 核心论点
1
同一问题的两个尺度——用户记忆(个体)与知识库(群体)共用向量检索、知识压缩等底层技术,同面信息冲突、知识过期、检索不准三大难题。
2
记忆提取三规则——选择性、抽象化、结构化;评估采用"基础回忆 → 多会话检索 → 主动服务"三层次框架。
3
四种存储格式是粒度递进——Simple Notes → Advanced JSON Cards;生产上"关键且少量用 Cards、大量非关键用 Notes"混合使用。
4
混合检索比任何单一策略稳健——稠密 + 稀疏 + 重排序;但把原始案例直接放进知识库远远不够,必须在索引阶段提炼、抽象、结构化。
5
知识更新是双轨机制——事件触发的增量更新(PR 式 Proposer-Reviewer 异源互审)+ 周期触发的全量整理;检索必须按调用者权限过滤。
6
双层记忆架构落地"主动服务"——Advanced JSON Cards 常驻概览 + 上下文感知检索按需取细节。
🗂️ 关键概念卡片
用户记忆
针对单个用户的个性化持久记忆跨会话提炼的稳定信息,与用户 ID 绑定,由工具显式读写
知识库
面向所有用户共享的集体知识法规、流程、专业文档等共享资料,与用户记忆共用检索技术
三层次评估框架
衡量记忆"好"的三级标尺基础回忆 → 多会话检索 → 主动服务,贯穿全章实验
四种存储格式
记忆"怎么存"的四种粒度Simple/Enhanced Notes、JSON/Advanced JSON Cards——简单性递减、表达力递增
User as Code
把用户状态建成可执行代码带类型状态+预写日志+检查点,聚合/冲突/约束交给确定性函数
RAG
检索增强生成检索相关片段 → 注入上下文 → LLM 基于上下文生成答案
嵌入(稠密/稀疏)
文本的两种向量化方式稠密:语义相近向量距离近;稀疏:词袋 + TF-IDF/BM25 精确匹配
混合检索与重排序
两全其美的检索流水线并行检索 → RRF 融合 → 神经重排序(跨编码器精排,双编码器初筛)
智能体化 RAG
Agent 主导的迭代检索把检索当工具,ReAct"思考→行动→观察"循环,直到信息充分
知识图谱 / GraphRAG
实体-关系网络索引三元组建图,原生支持多跳推理与实体消歧;RAPTOR 则用树状层次摘要
上下文感知检索
给分块"补前缀、加背景"索引期用 LLM 生成上下文前缀再拼接索引,同时增强稠密与稀疏检索
🖼️ 原书配图详解 · 记忆系统
图 3-1 本章知识脉络——用户记忆(个体)与知识库(群体)两列,汇合于共享检索技术,最终指向双层记忆架构
图 3-2 四种记忆策略对比——四张卡片各列优缺点,底部"简单性 → 表达力"递进轴
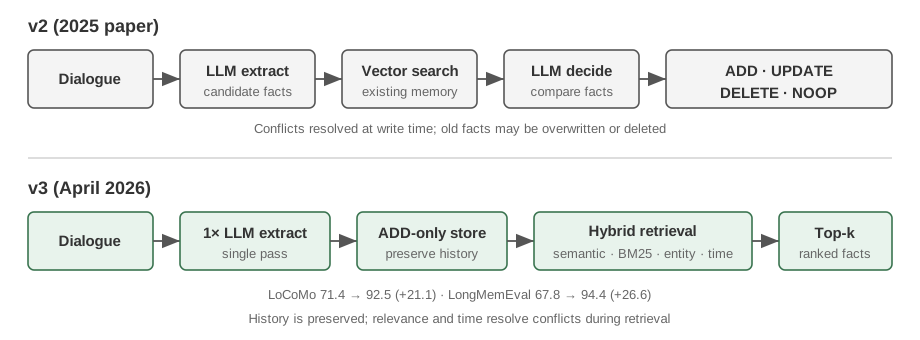
图 3-3 Mem0 记忆管理架构——v2 提取→向量检索→LLM 决策 ADD/UPDATE/DELETE/NOOP;v3 仅追加 + 混合检索
图 3-4 多类型记忆协同参考架构——工作记忆居中,与情景/语义/程序三类长期记忆双向交互
🖼️ 原书配图详解 · RAG 技术栈
图 3-5 RAG 查询流程——查询 → 检索(稠密+BM25)→ 增强 → 生成四步,附"故意杀人罪"数据流示例
图 3-6 稠密嵌入技术演进——Word2Vec/GloVe/BERT/Sentence-BERT/BGE-M3 时间线,静态词向量 → 上下文感知
图 3-7 HNSW 索引结构——多层稀疏图(Layer0 全节点 → Layer2 长程),搜索自顶层下钻
图 3-8 BM25 评分机制——词频饱和(k1)、逆文档频率、长度归一化(b)三块公式拆解
图 3-9 混合检索与重排序流水线——稠密+稀疏并行检索 → RRF 结果融合 → 神经重排序 → Top-N 精排
图 3-10 RAPTOR 树状层次索引——叶子文本块 → 聚类摘要 → 全局摘要,自下而上递归抽象
图 3-11 GraphRAG 实体-关系知识图谱——用户-张医生A/B-医院-地址关系网,标注多跳路径
图 3-12 智能体化 vs 非智能体化 RAG——左:一次性检索直答;右:思考-行动-观察迭代循环
图 3-13 智能体化 RAG 系统架构——ReAct 循环连接查询/回答、工具层与可切换知识库后端
图 3-14 上下文感知检索——传统分块的歧义 vs 前缀锚定;索引期流程:分块 → LLM 生成前缀 → 索引
图 3-15
结构化知识提取流水线
阶段一:判例 → LLM 因子发现 → JSON;阶段二:向量化 → KMeans 聚类 → 因子重要性模型 → 咨询 Agent——从数据中挖掘隐性知识
📊 关键案例与数据
| 案例 / 数据 | 要点 |
|---|---|
| 订机票例子 | 从对话提取"靠窗座位、素食、MileagePlus 12345678",演示选择性/抽象化/结构化三规则 |
| 黑猫白猫计数 | 100 案例(90 黑/10 白)受 top-k 截断致错误结论——需索引阶段预生成统计摘要 |
| Mem0 v3 | LoCoMo 71.4 → 92.5(+21.1);LongMemEval 67.8 → 94.4(+26.6) |
| Anthropic Contextual Retrieval | 检索失败率 ↓49%;加 BM25 与重排序后 ↓67%;每百万文档 token 成本约 1 美元 |
| LoCoMo 基准 | 平均约 300 轮、最多 35 个会话的超长多轮对话 |
💬 金句摘录
前者让 Agent 成为"懂你的助手",后者让 Agent 成为"领域专家"。(用户记忆 vs 知识库)
把原始案例或文档不加处理地直接放进知识库是远远不够的。
一个在做加法(补上下文),一个在做减法(去冗余)。(上下文感知检索 vs 上下文感知压缩)
智能体化 RAG 的价值在于其"解决问题"而非"回答问题"的能力。
🧪 配套实验亮点
实验 3-1/3-2 user-memory(★★)三层次框架评估四种存储格式
实验 3-8/3-9 agentic-rag(★★)中文司法问答 + 多会话检索
实验 3-10/3-11 上下文感知检索(★★)失败率降 49–67%;双层记忆主动预警
实验 3-12 CAIL2018 判例挖掘(★★★)因子发现 → 聚类 → 量刑顾问