🎯 上下文工程
全书技术密度最高的核心章:系统回答同一问题——"怎样以更低成本向模型提供一个信息充分的上下文"。上下文决定 Agent 能力上限,而不仅是对话历史。
🎯 核心论点
1
上下文质量才是关键——中等模型 + 精心组织的上下文,往往胜过顶级模型在信息匮乏下的盲目摸索;翁家翌:"人和模型一样,最重要的是 Context。"
2
API 无状态,框架每次重建上下文——Agent 的下一步行动取决于截至当前的完整交互上下文,生产系统可摘要压缩,但不能悄悄丢掉决定下一步所需的信息。
3
上下文 = 静态前缀 + 轨迹——"前面不能动、后面可以压缩";system/user/assistant/tool 四种角色 + tools 字段恰好覆盖第一章的五个组成部分。
4
KV Cache 利用前缀不变性,缓存经济性成为架构约束——动态信息永远追加末尾,静态前缀字节级稳定。
5
上下文学习本质是检索而非推理——状态栏把隐式状态提炼为显式知识;压缩把"需思考的结论"变成"可直接检索的知识",两者是一枚硬币的两面。
6
提示注入是核心安全威胁——防御核心是"指令/数据分离",但只能降低成功率,必须配合执行层与数据层。
🗂️ 关键概念卡片
上下文工程
设计 Agent 每次能看到什么系统性地设计、组织和提供 AI 完成任务所需的全部背景知识,是 Harness 中"上下文与工具"层的核心实现
四种消息角色
消息列表的身份标签system/user/assistant/tool 对应系统提示词、用户输入、模型回复、工具结果;tools 是独立字段
KV Cache
缓存前文中间计算缓存已算 token 的 K、V 向量,新 token 只算新增部分;首个不同 token 起缓存失效
Prompt Cache
跨请求的前缀复用推理引擎在多次 API 请求间复用相同前缀的计算结果,读取成本约为首次计算的 1/10
Chat Template
消息的"信封格式"把结构化 API 消息转成模型训练时见过的线性 token 流,特殊标记划分消息边界与角色
提示注入
恶意指令混入上下文攻击者借外部内容(网页/邮件/文档)把伪装指令混入上下文,劫持 Agent 行为
Agent Skills
按需加载的知识包能力模块化为 SKILL.md:YAML 元数据目录常驻,选中后才加载正文与子文档(渐进式披露)
Agent 状态栏
手机顶部的状态栏框架在上下文末尾以 user 消息槽位注入结构化状态摘要(TODO/工具计数/环境观察)
上下文压缩
给上下文做减法两次 API 调用之间由框架把原始工具结果替换为摘要;静态前缀永不动,接近阈值时批量压缩
上下文腐化
装得下但找不到了上下文未满但注意力被分散、关键信息检索不到,决策质量悄然下降(区别于窗口溢出)
子 Agent 上下文隔离
用隔离代替压缩把产生海量中间内容的探索委派给子 Agent,主上下文只收几百 token 的结论摘要
🖼️ 原书配图详解 · API 结构与注意力
图 2-1 上下文窗口的构成概览——章首总览系统提示词、工具定义、对话历史等全部组成
图 2-2 单轮 API 调用的请求与响应结构——最简 system+user → assistant 交互
图 2-3 两次模型 API 调用的完整交互序列——"请求→tool_calls→框架执行→送回结果→再请求"的 ReAct 循环 API 实现
图 2-4 Agent 每次调用模型时的上下文构成——静态前缀(上)+ 动态轨迹(下)
图 2-5 本地 LLM 工具调用架构(实验2-1)——API 消息经 vLLM/Ollama 服务端转成模型 token 流
图 2-6 注意力机制的直观理解——用"北京的天气怎么样"演示 Q/K/V 打分,上方匹配结果、下方三角形热力图
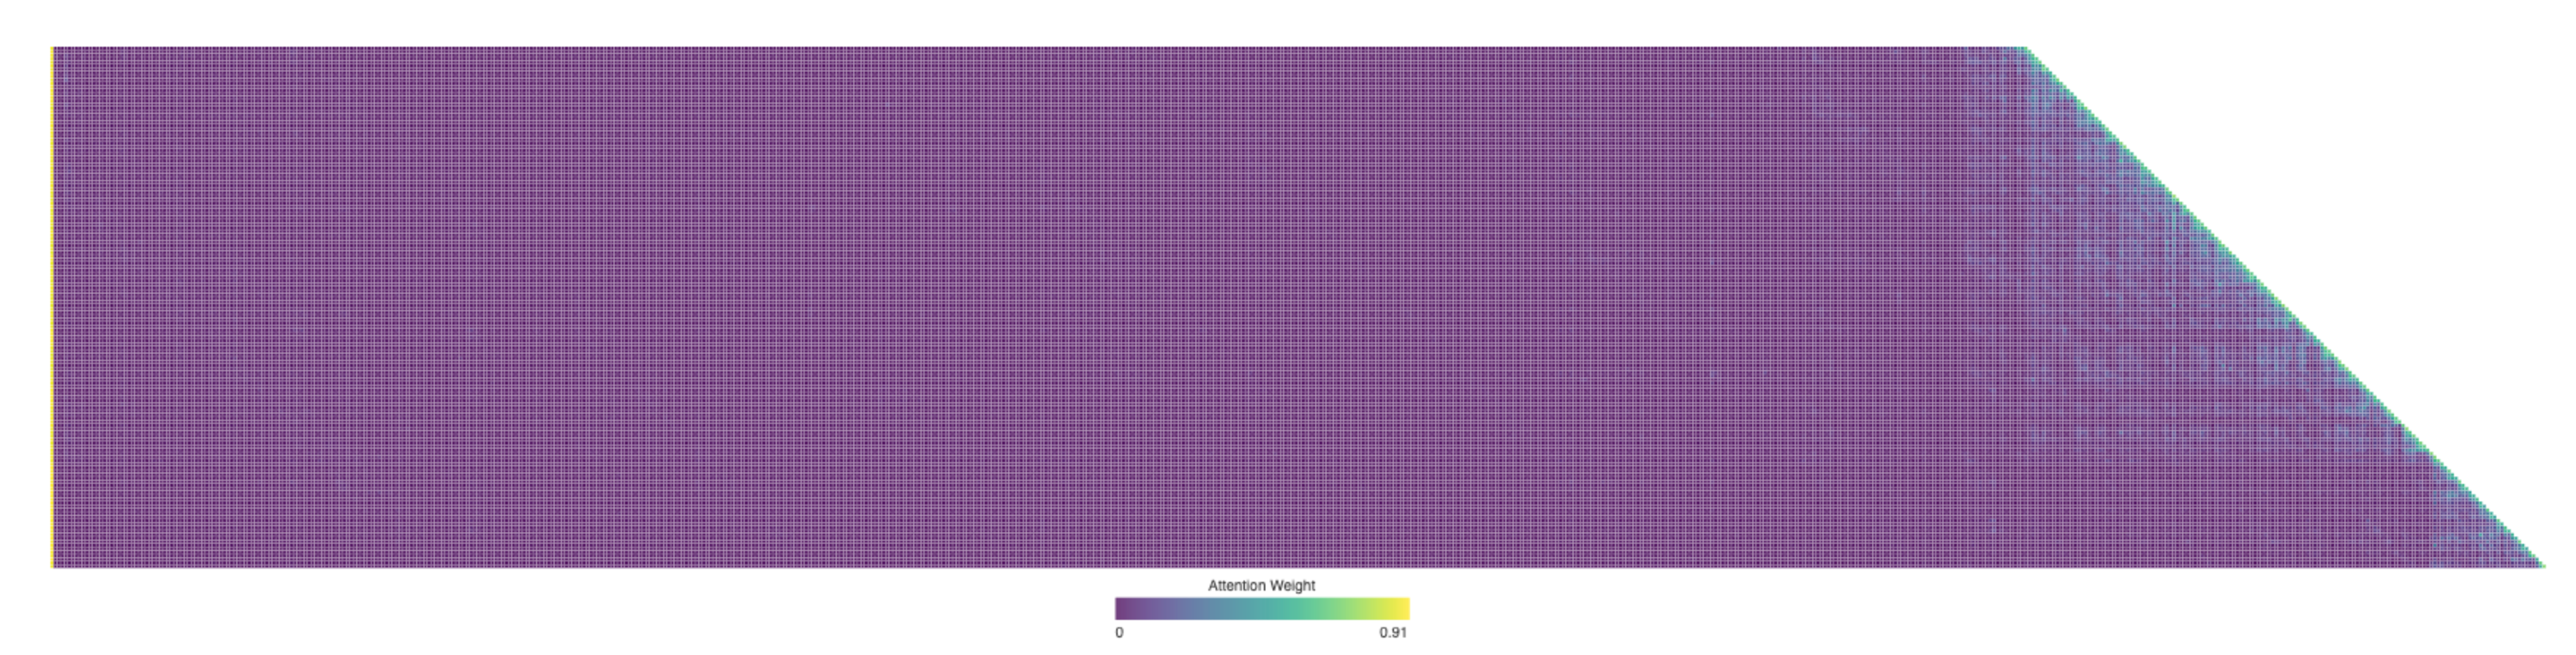
图 2-7(真实模型) 注意力热力图——Attention Sink(首 token 吸收超 70% 权重)、思考/输出双三角形、位置偏好
图 2-8 Chat Template 的 Token 结构——
<|im_start|> 等特殊标记划分消息边界与角色
图 2-9 API 消息到模型 Token 流的转换——左侧 JSON 消息与右侧线性 token 流对照
图 2-10 KV Cache 前缀复用机制——前缀命中 ✓ / 动态时间戳注入致缓存失效 ✗,附 TTFT 与成本对比
🖼️ 原书配图详解 · Skills 与状态栏
图 2-11 Skills 渐进式披露机制——元数据目录 → 核心流程 → 子文档 三层按需加载
图 2-12 启用 Skills 后 Agent Trajectory 的完整结构——tool_use→占位 tool_result→正文以 user 消息追加
图 2-13 KV Cache 随 Agent Trajectory 增长的演化——前缀稳定、正文按需加载时缓存持续命中
图 2-14 Agent 状态栏架构——任务进度/工具调用计数/环境状态汇总为状态摘要注入上下文
图 2-15 Agent 状态栏在 API 消息列表中的插入位置——以 user 消息追加到轨迹末尾,紧邻生成位置获得最高注意力
图 2-16 上下文压缩策略对比——静态前缀不动、只压缩 tool results、接近阈值批量压缩
图 2-17
六种压缩策略的处理流程
无压缩 / 个体摘要 / 组合摘要 / 上下文感知 / 带引用 / 自适应窗口化——六策略流程对照。实验2-10 显示上下文感知压缩比非任务感知少用 75%+ token。
📊 关键案例与数据
| 案例 / 数据 | 要点 |
|---|---|
| 客服 Agent 时间戳事故 | 每天 10 万次对话,系统提示词注入 Current time: {{now}} 后首 token 延迟 0.5s → 3-5s,月度账单几乎翻倍 |
| 提示工程消融(Tau-Bench) | 保留规则但打乱组织结构 → 任务成功率下降超 30%;移除工具描述 → 工具调用错误率增加 45% |
| 六种压缩策略(Kimi K3) | 无压缩第 5 次迭代即超限;上下文感知压缩仅 7 次迭代、压缩率约 3.0%,整体减少 token 使用量 75% 以上 |
| Agent 状态栏 | 小开源模型准确率接近前沿大模型,思考 token 量/延迟/花费降低约一个数量级;详细错误信息使替代方案成功率 60% → 95% |
| Attention Sink | 首 token 是"注意力储存池",吸收超 70% 权重;存在 Lost in the Middle 位置偏好 |
💬 金句摘录
人和模型一样,最重要的是 Context。(翁家翌)
AI Agent 就像一个永远的新员工:给足背景信息,它能干得很好;什么都不告诉它,再聪明也是白搭。
不要让模型被动地在海量信息中检索,而要主动为模型提供经过提炼的结构化知识。
在设计 Agent 架构时,缓存经济性不是事后优化,而是前置约束。
🧪 配套实验亮点
实验 2-1 本地 LLM 工具调用(★)vLLM/Ollama 服务端消息转换
实验 2-2 注意力机制可视化(★)Attention Sink / 双三角形 / 位置偏好
实验 2-3 KV Cache 错误模式(★★)五种有害上下文管理方式系统性验证
实验 2-4 提示工程消融(★★)Tau-Bench 组织结构与工具描述
实验 2-8/2-9 Agent 状态栏(★★)五种可独立启用的状态栏技术
实验 2-10 六种压缩策略对比(★★★)"压缩即理解"与 80% 阈值批量压缩